Штучний інтелект в мережі: скільки контенту тепер створюють машини?
У листопаді 2022 року світ побачив ChatGPT від OpenAI, і менш ніж за чотири роки штучний інтелект увійшов у повсякденне життя майже половини дорослих у США, 24% з яких користуються чат-ботами щодня. Цей вибух AI-технологій породив нагальне питання: якою мірою сучасний інтернет наповнений текстами, створеними штучним інтелектом, а не людьми?
Розгортання AI-контенту: де він зустрічається найчастіше?
Розподіл штучно створеного тексту в інтернеті нерівномірний. Спочатку, одразу після запуску ChatGPT, типові стилістичні ознаки AI-авторства були приблизно однаковими на різних основних доменах: .com, .org, .edu та .gov.
Нині ситуація змінилася:
- Порядку 10% вебсторінок у доменній зоні .com мають ознаки AI-генерованого тексту.
- Домен .org демонструє приблизно 4,6% таких сторінок.
- У зонах .edu та .gov частка таких просунь становить всього близько 1%.
Чому AI-текст частіше зустрічається на комерційних сайтах?
Комерційні платформи часто прагнуть швидко наповнити контентом свої сторінки. Штучний інтелект допомагає пришвидшити цей процес, підсилюючи масштабність публiкацiй. Освітні та урядові ресурси, навпаки, більш обачливо ставляться до достовірності та якості інформації, відтак рідше використовують AI для створення основного тексту.
Як розпізнати AI-літературу: основні ознаки
Моделі штучного інтелекту, навчальні на великій кількості людських текстів, часто несвідомо переймають певні стилістичні елементи, які в наслідок перетворюються на характерні для них мовні «затримки». Ось чотири найпоширеніші риси AI-тексту:
- Ем-даш (—) — машинні тексти використовують цей тире набагато частіше, ніж усередньому це роблять люди.
- Оксфордська кома — штучний інтелект уникає двозначностей, активно виділяючи елементи списків комами.
- Типові фрази та слова — наприклад, «досліджувати», «ключовий», «підкреслювати», «важливий» і подібні, що відображають формальний стиль.
- Негативний паралелізм, як-от конструкції на кшталт «це не тільки X, а й Y», який останнім часом значно зростає у використанні AI.
Порівнюючи статистику з 2023 року та теперішній час, бачимо, що:
- Двократне зростання застосування ем-дашу;
- Використання Оксфордської коми зросло на 63%;
- Поширеність AI-специфічної лексики більше ніж подвоїлась;
- Трійне збільшення випадків негативного паралелізму.
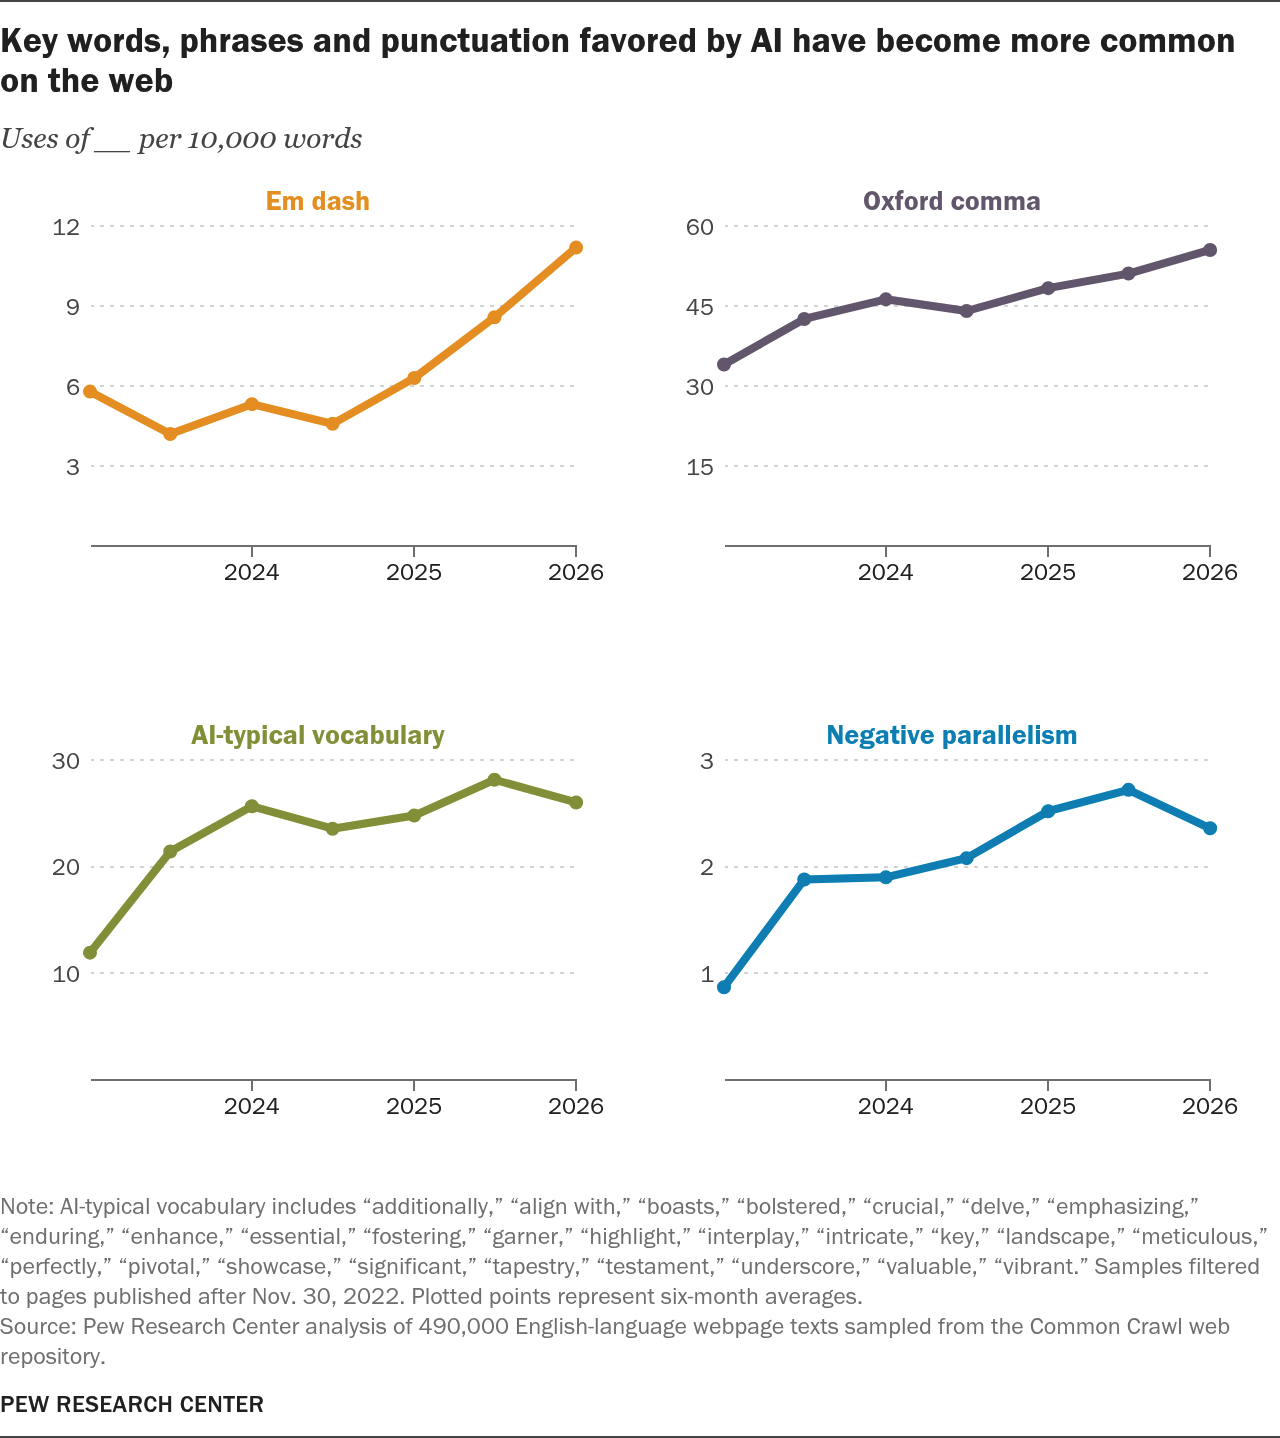
Деталі, що допомагають розпізнавати AI-авторство
Звісно, лише наявність тире або Оксфордської коми не означає, що текст написаний машинним інтелектом. Ці елементи використовуються і людьми. Проте, коли ми розглядаємо тисячі документів разом, виявляються важливі закономірності в лексичних і синтаксичних прийомах. Сучасні AI-детектори аналізують не тільки окремі слова чи знаки пунктуації, а й складні мовні патерни, що дозволяє ефективно визначати AI-генерований текст.
Проаналізовано: як проводилось дослідження
Цей аналіз реалізовано дослідниками Pew Research Center за допомогою даних Common Crawl, зібраних у період із січня 2021 до липня 2026 року. Для виявлення текстів, створених або істотно відредагованих штучним інтелектом, застосували модель Open Pangram, яка розрізняє лінгвістичні особливості, характерні для машинного авторства.
Вивчення статистики на дуже великому масиві документів дало змогу прослідкувати динаміку поширення AI-контенту і виявити тенденції зміни мовних патернів в онлайні.
Хто працював над дослідженням
У цьому дослідженні брали участь провідні науковці та експерти Pew Research Center: Самуель Бестватер (старший дата-сайентист та автор статті), Карсон ТерБуш (дизайнер та розробник графіки), Крис Барановські (ведучий інженер), Янкі Чавда (продюсер), а також команда аналітиків і редакторів.
